
Der aktuelle KI-Markt tendiert zu einer Konzentration auf wenige, große Anbieter. Das Geschäftsmodell dieser geschlossenen Cloud-Systeme ist oft durchschaubar: Sie möchten Ihre Daten in ihre Ökosysteme ziehen, verbunden mit laufenden, monatlichen Kosten. Ein späterer Wechsel ist meist mit hohen Hürden verbunden. Auch: »Vendor-Lock-in« genannt.
Dazu kommt ein Bauchgefühl, das viele von uns kennen: Haben Sie wirklich ein gutes Gefühl dabei, hochsensible, interne Unternehmensdaten an Server zu schicken, die physisch auf einem anderen Kontinent stehen?
Doch lokale KIs (Open Source-LLMs) setzen mitunter sehr hohe Ansprüche an Rechenpower voraus. Vor jedem Start muss das komplette LLM in Ihren Arbeitsspeicher geladen, die Kontextläge festgelegt werden etc.
Das »MP3-Prinzip« in der KI: Warum gezielte Präzision besser ist als brute force
Stellen Sie sich vor, Sie müssten für jede kleine Anfrage in Ihrem Unternehmen erst das gesamte Firmenarchiv auf den Tisch kippen, nur um ein Problem lösen zu können, was im Zusammenführen von zwei Ihrer Dokumente löst. Unlogisch, oder?
Genau so ist die Methodik aktueller KI-Modelle. Sie laden für jede Antwort den kompletten, riesigen Wissensspeicher in den Arbeitsspeicher. Das kostet viel Energie, viel Hardware und damit viel Ressourcen.
Das Container-Prinzip für LLMs oder 35-Milliarden-Parameter im MP3-Moment der KI
Doch es gibt zwischendurch einmal eine ziemlich coole Idee. Ein Ansatz, der nicht auf »alles laden« setzt, sondern auf gezielte Effizienz. Und dieser Ansatz hat viel mit einem Prinzip zu tun, das wir alle bereits seit Jahrzehnten nutzen: dem MP3-Format.
Die Idee der Wissens-Container
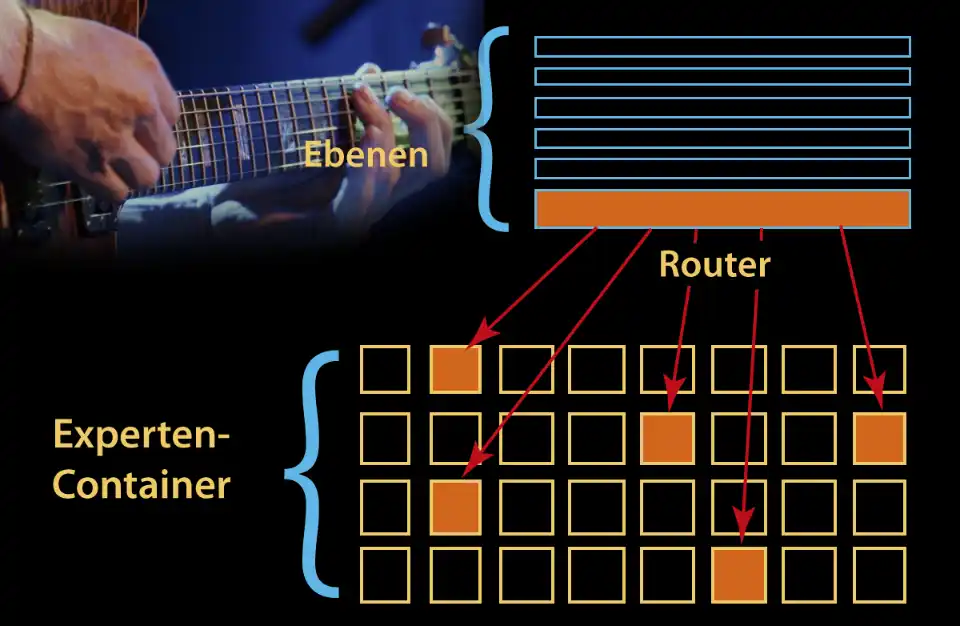
Moderne KI-Experten entwickelt derzeit Frameworks, die große Sprachmodelle in zig kleine »Experten-Container« aufteilen.
Stellen Sie sich diese Container wie gut beschriftete Archivboxen vor. Jede Box enthält nur ein ganz spezifisches Fachwissen. Wenn Sie eine Frage stellen, analysiert ein intelligenter Router zunächst die Anfrage. Er entscheidet dann: Welche Boxen werden für diese spezifische Antwort wirklich benötigt?
Nur diese wenigen Container werden im exakten Moment der Verarbeitung aktiv geladen. Der Rest bleibt inaktiv auf der Festplatte. Das Ergebnis? Ein massives KI-Modell kann plötzlich auf ganz normaler Hardware laufen, weil es nur noch einen Bruchteil des Arbeitsspeichers belegt.
Der MP3-Vergleich: Akzeptabler Tausch für massive Effizienz
Wir alle kennen das Prinzip: Das MP3-Format hat die Welt verändert, nicht weil es die perfekte Audioqualität lieferte, sondern weil es den richtigen Kompromiss fand. Es hat Frequenzen entfernt, die das menschliche Gehör kaum wahrnimmt. Der Qualitätsverlust in einigen Frequenzbereichen war für den Alltag vernachlässigbar. Der Gewinn an Speicherplatz war jedoch revolutionär.
Was wäre also, wenn nicht das gesamte LLM geladen werden würde, sondern es einen Layer vor den ersten Layern gäbe, die den eigentlichen Prompt erst auseinandernehmen? Also einen »Router«, der gezielt nur die Experten auswählt, die notwendig sind, um die Frage beantworten zu können?
Durch eine leichte Kompression und das gezielte Laden von Containern entsteht jedoch, dass muss unbedingt gesagt werden, ein minimaler theoretischer Genauigkeitsverlust. Doch für 95 Prozent aller praktischen Anwendungen ist dieser Verlust nicht spürbar. Der Gewinn an Geschwindigkeit, Kostenersparnis und lokaler Einsetzbarkeit wiegt diesen kleinen Nachteil um ein Vielfaches auf.
Digitale Souveränität und unternehmerische Vernunft
Dieses Container-Prinzip stößt an seine Grenzen, wenn es um breite, philosophische oder hochgradig vernetzte Fragen geht. Wenn die KI bei jedem einzelnen Wort in einen völlig anderen Wissensbereich springen muss, entsteht ein Stau im System.
Aber: Im geschäftlichen Alltag stellen wir diese philosophischen Fragen selten.
Wir stellen spezifische Fragen.
- »Erstelle eine Zusammenfassung dieser Kundenfeedbacks.«
- »Formuliere eine Antwort auf diese konkrete Reklamation mit den Bestandteilen X, Y, Z.«
- »Analysiere diese Tabelle auf Auffälligkeiten.«
Für genau diese spezifischen, klaren Aufgaben ist die Container-Architektur wie maßgeschneidert. Die KI lädt nur den »Kommunikations-Container« oder den »Datenanalyse-Container«. Sie arbeitet ressourcenschonend, blitzschnell und präzise.
Fazit: Intelligenz bedeutet nicht Größe
Die Zukunft der KI im Unternehmen liegt nicht darin, immer teurere Server zu kaufen. Sie liegt in der klugen Architektur.
Es geht darum, Werkzeuge zu wählen, die so arbeiten, wie ein gutes Unternehmen geführt wird: Ressourcenschonend, fokussiert auf das Wesentliche, und ohne unnötigen Ballast. Eine gute Idee, wenn man bedenkt, dass auf Handys ebenfalls lokale LLMs laufen, könnten diese noch viel schlauer werden, denn sie laufen ja nur sauber, weil sie insgesamt sehr viel kleiner sind.
Glauben Sie, dass lokale Open-Source-KI auf Konsumenten-Hardware die Zukunft ist?
Hier der Link zur Inspirations-Quelle: https://www.youtube.com/watch?v=UPkyw0LwiMU

